从找到到判断:AI 时代的信息差
找信息早已不难,难的是找到之后不停下来。本文引斯坦福历史教育团队的评估研究与横向阅读实验,说明这个落差的测出结果,给出本院三步判断顺序,并如实交代内部统计样本小、方法粗的边界。
本文性质: 观察 + 实证(Observation / Evidence) 证据标签: 观察 Observation/模型 Model/假设 Hypothesis/实证 Evidence
本篇涉及的证据类型:观察 Observation/实证 Evidence/假设 Hypothesis。凡属本院课堂观察与教学模型的部分,均不作效果承诺。
找信息这件事在十几年里从难事变易事。但本院在高中与研究性学习中观察到,学生的困难位置已经移动:不再是找不到,而是找到之后不停下来——第一条结果就够写作业了,为什么要看第二条。
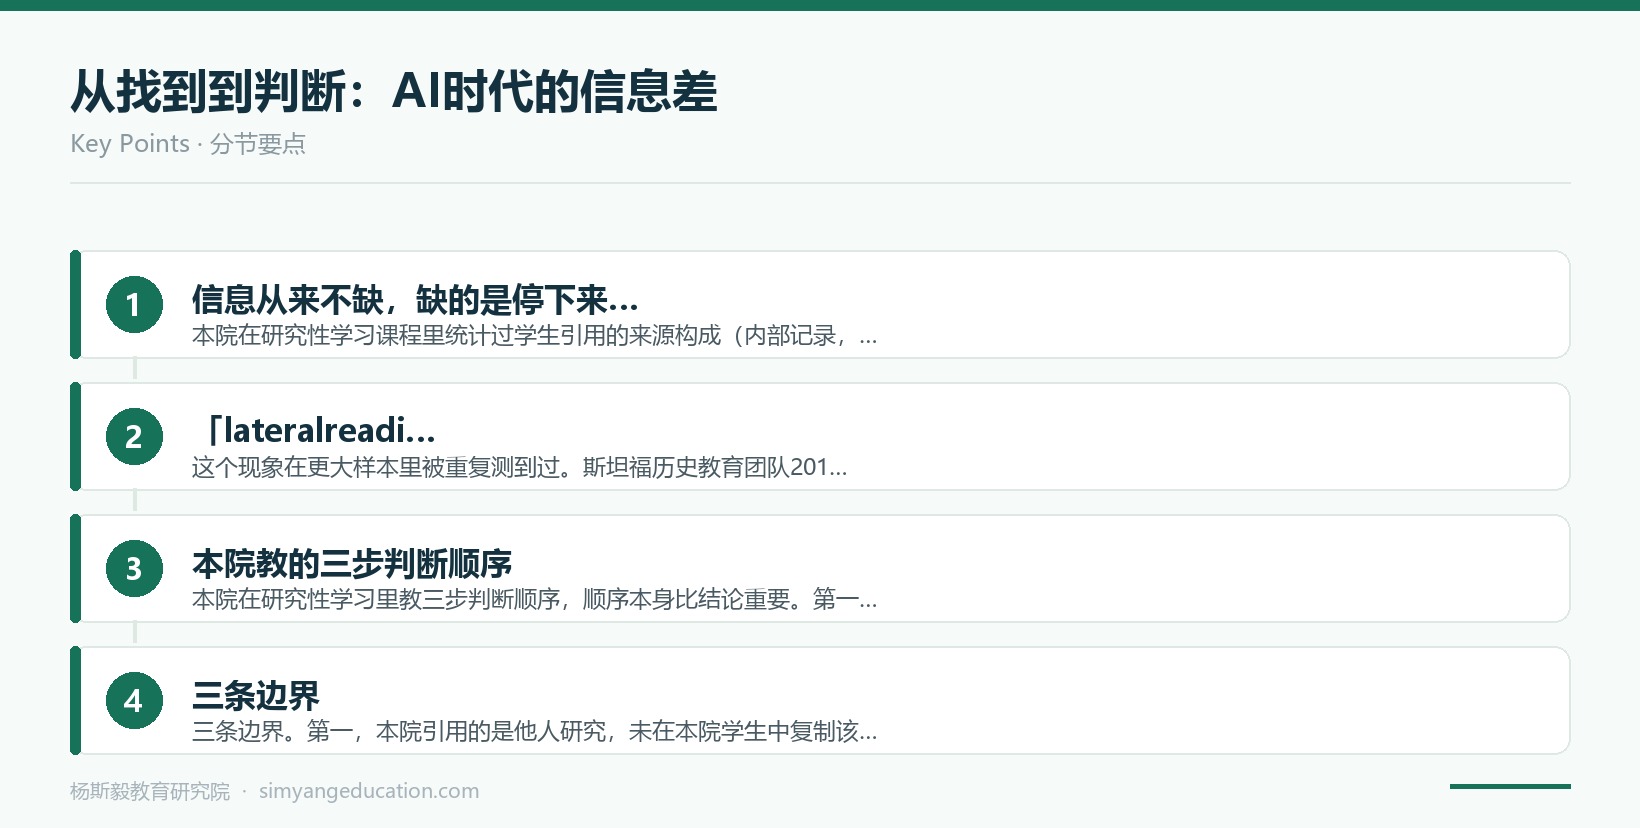
01信息从来不缺,缺的是停下来的理由
本院在研究性学习课程里统计过学生引用的来源构成(内部记录,样本为两届高中的课程作业):绝大多数被引用的页面来自搜索结果的前几位,几乎没有学生打开过发布机构的「关于我们」或作者署名页。另一个现象是:学生判断来源可信度的依据高度集中在「看起来专不专业」——排版好、术语多、没有错别字,就被认为可信。以上为本院课程记录,属观察层,样本与方法均有限。
02「 lateral reading 」与被测出的落差
这个现象在更大样本里被重复测到过。斯坦福历史教育团队 2016 的报告中,研究者让中学生判断一批网页的可信度,结果多数学生在排版精良但来源可疑的页面上给出了「可信」判断,且很少主动核查发布主体。Wineburg 等人在此后的研究中把专业事实核查员的策略概括为「横向阅读」:不停留在当前页面里读内容,而是立刻开新标签查这个发布者是谁、谁在资助、别处怎么评价它。后续的干预实验显示,这种策略可以被教会,且在课程结束一段时间后仍有残留效果。需要说明的是,这些研究的对象多为新闻与社交内容,迁移到学科学习场景需要谨慎。
03本院教的三步判断顺序
本院在研究性学习里教三步判断顺序,顺序本身比结论重要。第一步:先看发布者,再看内容。点开「关于」和作者页,用三十秒回答「这是谁发的、靠什么运转」。第二步:离开这个页面查它。新开一个搜索,看这个来源在别处的评价——这一步是横向阅读的核心动作。第三步:区分「事实」与「立场」。同一件事,两个来源给出不同数字时,先别判断谁对,先看两边的统计口径与时间范围是否相同。三步都不要求学生已经是某个领域的专家,只要求他们在「准备引用」之前多花两分钟。
04条边界
三条边界。第一,本院引用的是他人研究,未在本院学生中复制该实验,上述内部统计样本小、方法粗,只作现象描述。第二,三步顺序提高的是发现可疑来源的概率,不能保证每次都能识别,更不能替代领域知识。第三,本院不把「怀疑一切」当教学目标——目标是让引用这个动作慢两分钟,不是让学习者对所有来源失去信任。