听懂一句话,靠的不是词汇量
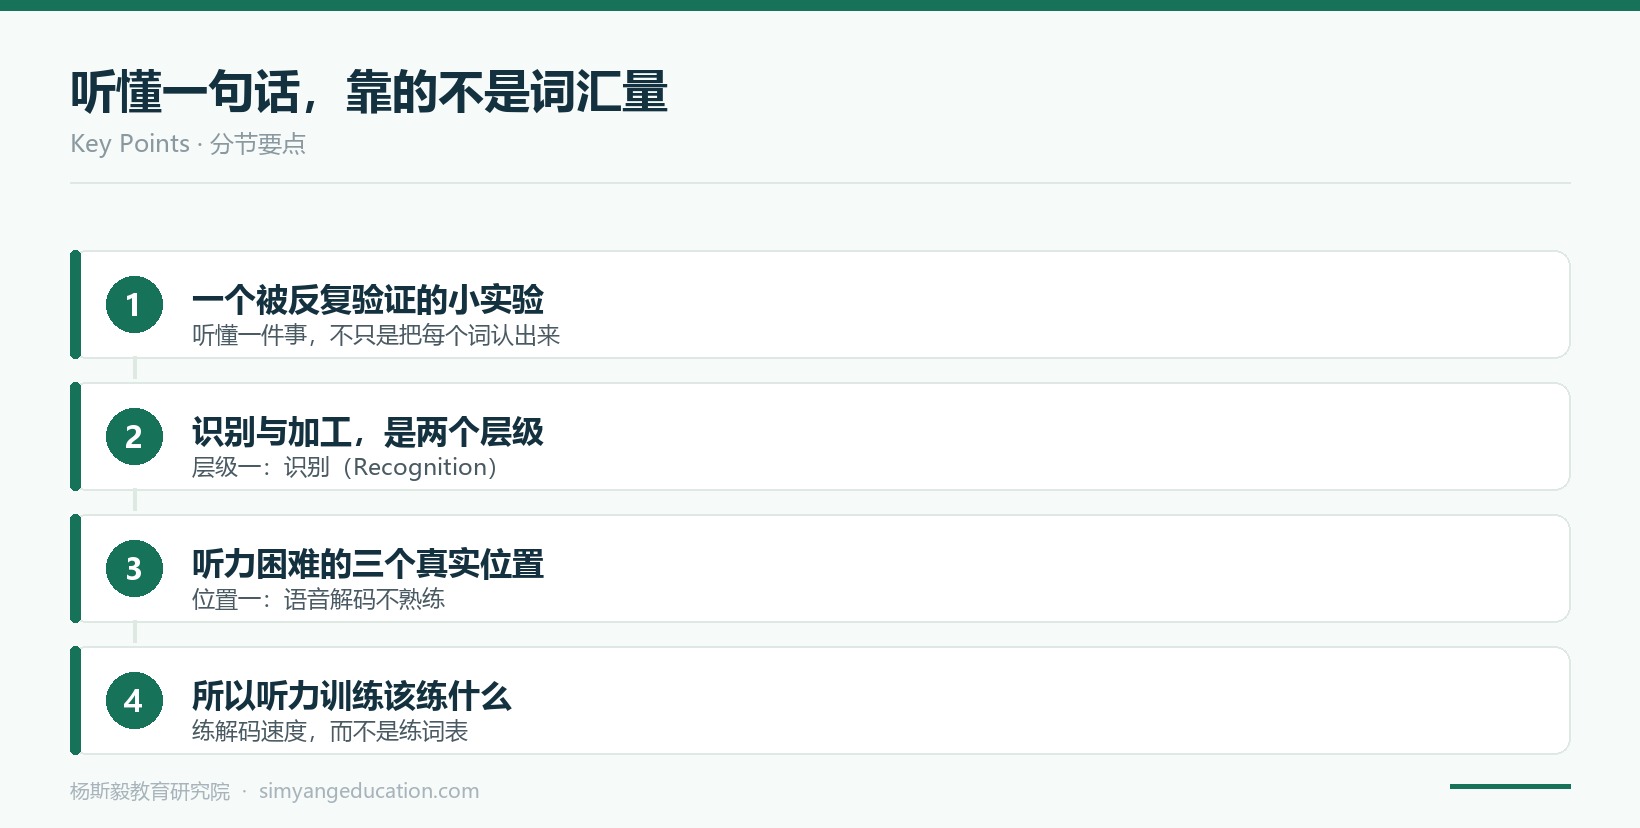
很多学生和家长的默认假设是:听不懂 = 单词不认识。于是听力问题被翻译成词汇问题,解决方案就是继续背词。但这个等式在课堂里经常失效——把每个词都写下来,学生依然听不懂。本文区分"识别"与"加工"两个层级,说明听力困难最常见的三个真实位置。
01一个被反复验证的小实验
在课堂上做过这样一件事:把一段听力材料放给学生听,他们表示听不懂。然后把原文逐词抄在屏幕上,请他们再听一遍。
如果"听不懂 = 词不认识",那么现在每个词都认识了,应该就能听懂了。
实际情况是:大部分人依然觉得跟不上。
这个结果不新鲜,但每次都很有效——它说明听懂一件事,不只是把每个词认出来。
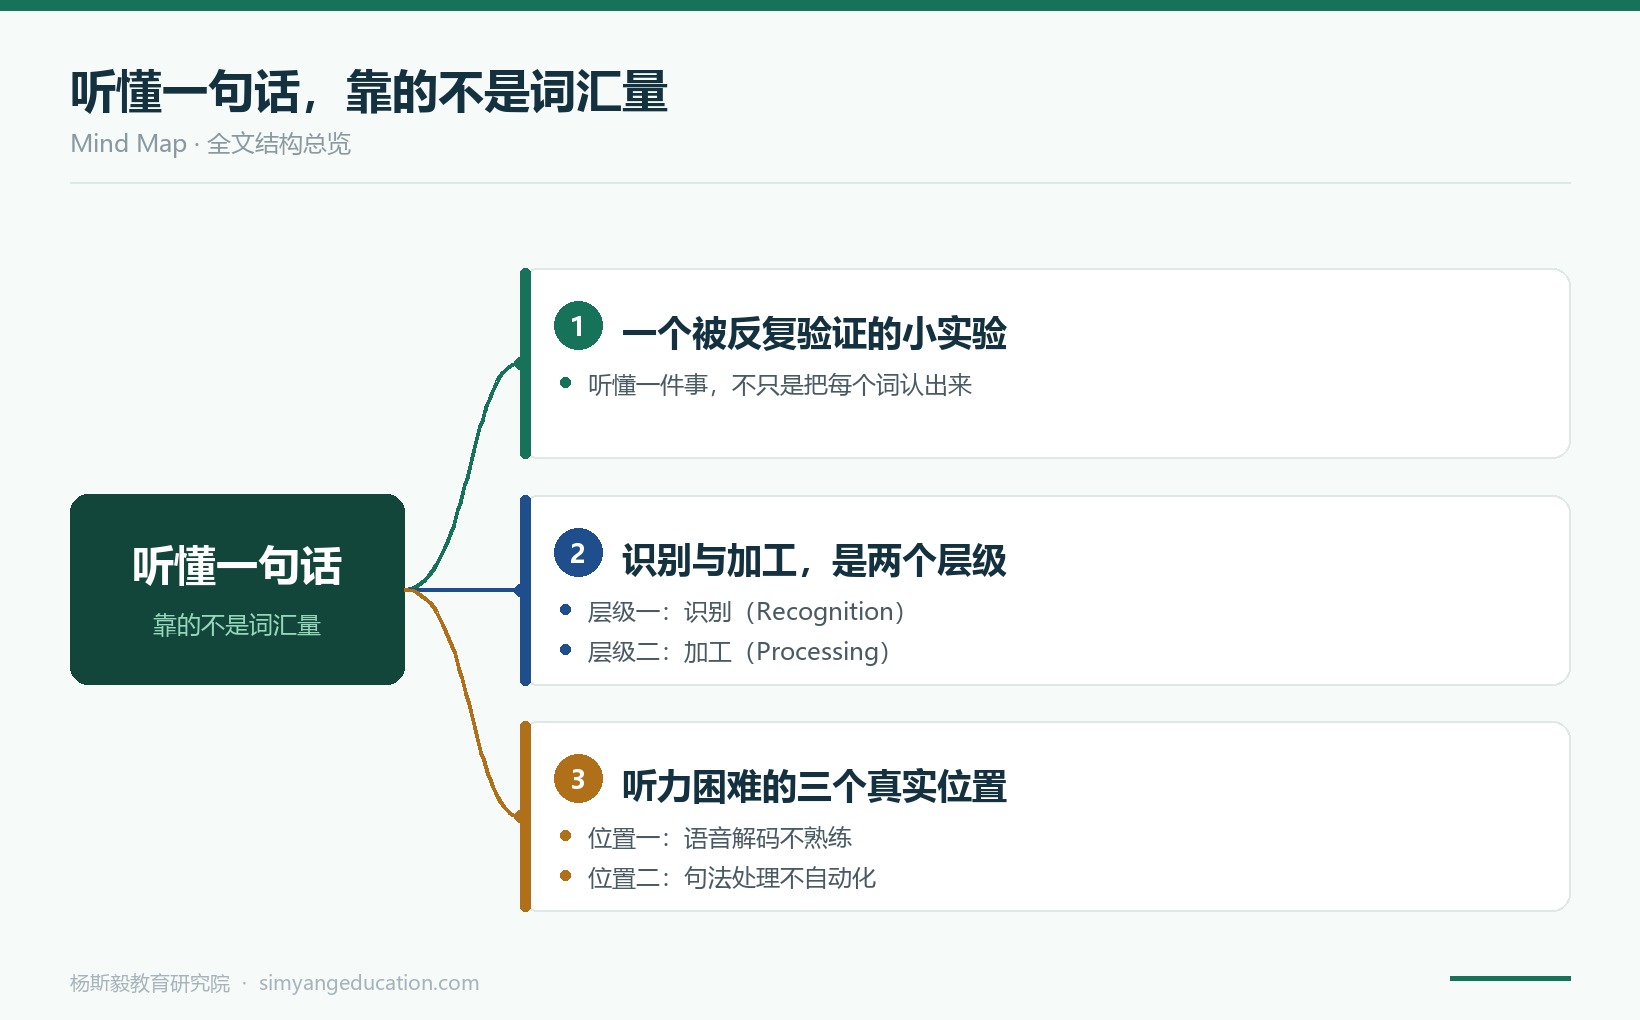
02识别与加工,是两个层级
在认知科学里,从声音到理解至少有两个层级:
层级一:识别(Recognition)。 把连续的语音流切成词,认出这个声音对应哪个词。这需要语音解码能力——分辨连读、弱读、重音位置、语调走向。很多学生的困难卡在这里:他认识 `acquire` 这个拼写,但听到它在句中被弱读过,就认不出来了。
层级二:加工(Processing)。 把认出来的词串成结构,建成意义。这个过程依赖工作记忆——它像一个容量很小的操作台,同时处理"刚才听到了什么"和"这句话在说什么"。
工作记忆的容量是有限的。这意味着:如果层级一消耗了太多容量,层级二就没有余量了。
03听力困难的三个真实位置
把上面这个框架放回课堂,听力困难基本上落在三个位置。
位置一:语音解码不熟练。 学生需要用意识去"拼"每个词,这个过程慢且耗容量。表现是:一句话听完,前面几个词已经忘了。这不是记性差,是解码占满了操作台。
位置二:句法处理不自动化。 遇到长句时,学生要停下来分析结构,而这个停顿让后面的内容漏掉了。表现是:单句能懂,连成段就断片。
位置三:停在"逐词翻译"上。 有些学生听的时候在心里逐个翻译成中文。翻译本身要占用容量,而且中文语序与英文不同,译完再拼回意义,时间早就过去了。
注意:这三个位置,都不主要是"词汇量不足"。词汇量不足会造成生词卡顿,但它不是"每个词都认识却听不懂"的原因。
04所以听力训练该练什么
如果上面的分析成立,听力训练的着力点就要换一换:
- 练解码速度,而不是练词表。 用跟读、影子练习(shadowing)把高频语音块变成条件反射,让识别不再占用容量。
- 练"块",而不是"词"。 母语者听的是语块,不是单个词。让学生积累 `as far as I know`、`the thing is` 这类固定块,能显著减少处理负担。
- 练容错,而不是练精确。 允许漏掉几个词继续往下听。追求每个词都抓住的学生,往往反而什么都抓不住。
最后一条常被忽略:听不懂是常态,不是失败。 母语者听母语也会漏词——他们只是不停下来。