听辨的鸿沟:听得懂每个词,不等于译得出来
2026-10-29 11:39:25
0
本文导读
「每个词都认识,连起来就懵」——这不是词汇问题,是听辨加工的问题。本文从认知科学讲清这条鸿沟的成因,并给出对应的训练顺序。

图 1 听辨的鸿沟:听得懂每个词,不等于译… —— 全文结构总览 · 点击图片可放大
本文性质: 模型 + 观察(Model / Observation) 证据标签: 观察 Observation/模型 Model/假设 Hypothesis
本篇的语音感知与工作记忆部分引用学界成熟研究;训练顺序为本院教学设计,不作效果承诺。
口译训练第一课常被学生问倒:「我词汇量够了,为什么还是听不懂?」把他们的听写拿来一看,单词几乎全对——问题出在更上游:听辨加工。听懂,从来不是把词一个个认出来,而是把连续声流实时切成结构并预装意义。这条流水线任何一环慢半拍,理解就断流。
01个常见的「假听懂」现场
- 连读吞音: an asset 听成 a set;not at all 连成一个音团。词表里认识,耳朵里陌生——因为「认识」是视觉词库的功劳,耳朵从没练过。
- 语流预判失败: 听到一半猜错句型走向,后半句全部对不上,被迫推倒重来。预测是听力的加速器,也是双刃剑。
- 逐词翻译挤占: 边听边在心里翻译,工作记忆被产出占满,真正的结构信息反而没进脑。这与 自动化反应一文讲的机制直接相关:练了三年的「边听边译」,成了自动化的障碍物。
02认知科学怎么看
口译与工作记忆的研究(Christoffels & de Groot 等)发现:口译表现与工作记忆容量相关,但更 related to 的变量是源语理解的自动化程度——理解越自动化,留给转换的记忆越多。换言之,先成为「不需要努力就听懂」的人,再谈翻译。这也是本院听力训练的排序原则:语音辨析 → 结构预判 → 意义群组,三关过了才上翻译。
03训练顺序:先修路,再跑车
- 语音辨析关: 最小对立对(ship/sheep)、连读弱读专项听写,把耳朵词库补齐。
- 结构预判关: 听前半句暂停预测后半句走向——练「猜错的恢复速度」比猜对率更重要。
- 意义群组关: 复述时不许逐词,只许按意群说大意——把「翻译冲动」从听力通道里摘出去。
顺序错了的典型症状:直接上翻译练习的学生,三个月后听力分数没变,倒是把「逐字对应」练得更熟了。方法不对时,努力只是在加固错误——策略不是方法一文讲的就是这个道理。
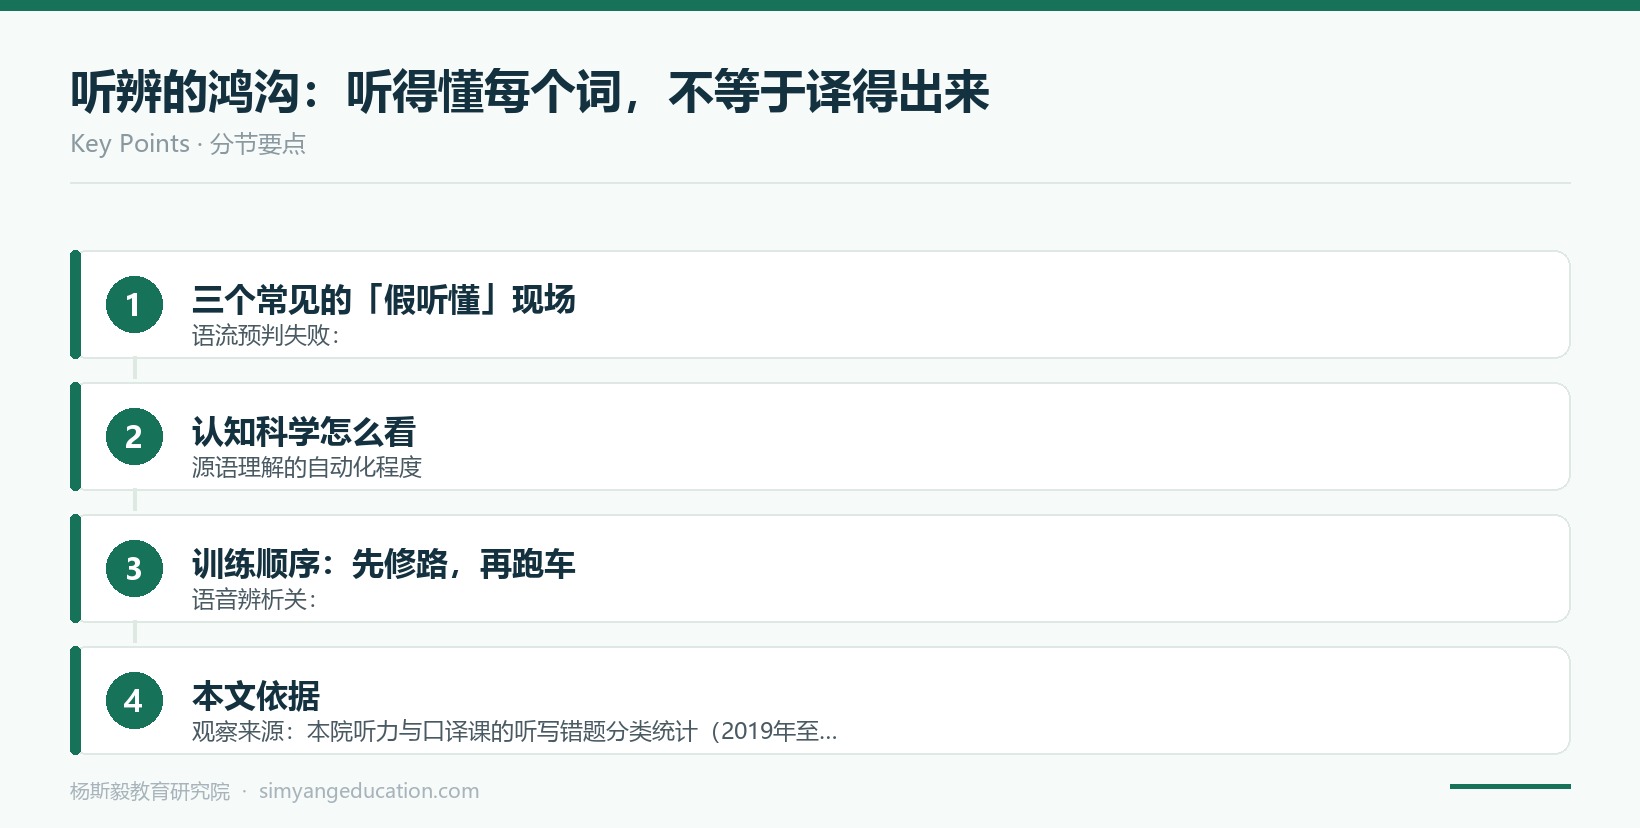
图 2 听辨的鸿沟:听得懂每个词,不等于译… —— 分节要点 · 点击图片可放大
本文依据
观察 Observation模型 Model
观察来源:本院听力与口译课的听写错题分类统计(2019 年至今),属课堂观察,未做统计检验。
模型出处:「语音辨析→结构预判→意义群组」三关训练序为本院教学模型,未见信效度检验。
待验证项:训练顺序对听力进步速度的影响,本院正在按学期追踪,样本未及分析。
外部文献:Christoffels, I. K. & de Groot, A. M. B. (2004) 口译中的工作记忆成分;Field, J. (2008).Listening in the Language Classroom;Gile, D. (2009)。
杨斯毅教育研究院
把研究放在课堂旁边 · 教育研究