AI 说得越肯定,越要停一下
换个问法答案就变了,语气却同样笃定——工具的表达不携带它的把握程度。本文说明语言模型的生成机制与幻觉的成因,给出降级提问、要求出处、找独立来源三步核对顺序,并交代它能降低风险但无法归零。
本文性质: 实证 + 假设(Evidence / Hypothesis) 证据标签: 观察 Observation/模型 Model/假设 Hypothesis/实证 Evidence
本篇涉及的证据类型:实证 Evidence/假设 Hypothesis/模型 Model。凡属本院课堂观察与教学模型的部分,均不作效果承诺。
同一个问题换一种问法再问一次,答案可能不一样;但两次的语气都同样笃定。工具的表达方式不携带它的把握程度,这一点必须由使用者自己补上。
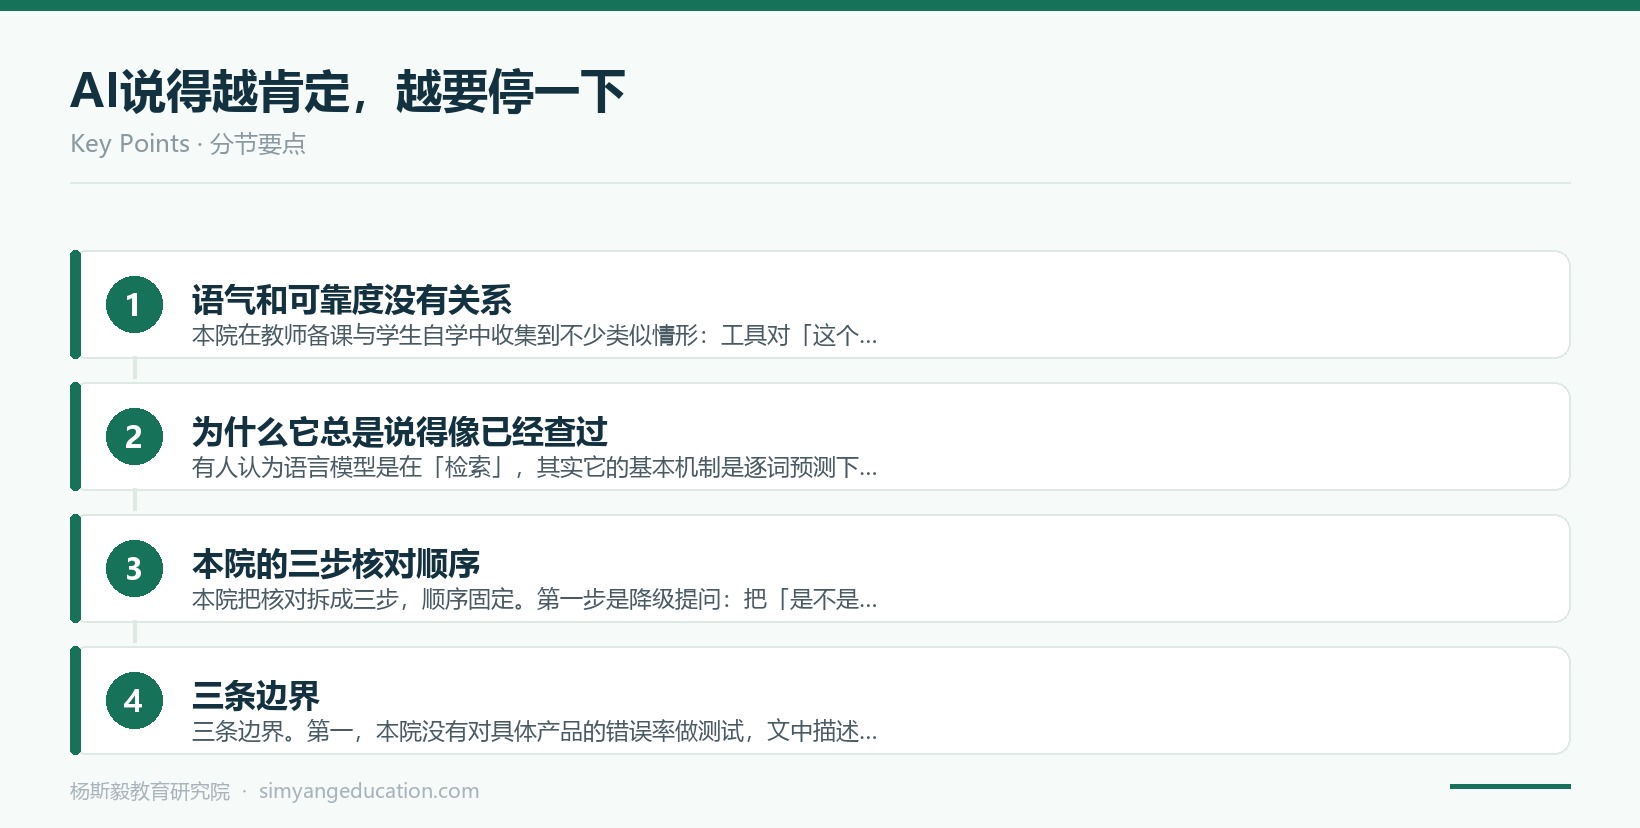
01语气和可靠度没有关系
本院在教师备课与学生自学中收集到不少类似情形:工具对「这个用法是不是标准」这类问题给出斩钉截铁的回答,语气体面、结构完整,但换个问法就变成另一个答案;也有人据此在课堂上讲了一个并不准确的说法,事后才发现。以上为本院教学记录中的观察,未做系统统计。值得注意的是,越是结构清楚、术语齐全的回答,越容易被当成权威。
02为什么它总是说得像已经查过
有人认为语言模型是在「检索」,其实它的基本机制是逐词预测下一个最可能的词(Bender 等 2021 把这一特征称为随机鹦鹉式的生成)。因此流畅度与事实性是两个独立维度:句子越顺,不代表内容越准。研究综述把「生成看似合理但不实」的输出称为幻觉,并指出其成因包括训练数据的不足与时效问题、训练目标与推理目标不一致等(Ji 等 2023)。另一方面,人本身也容易高估自己判断的准确度(Moore & Healy 2008 梳理了过度自信的三种表现)。工具与人叠加起来的双重过度自信,才是这套风险真正的来源。
03本院的三步核对顺序
本院把核对拆成三步,顺序固定。第一步是降级提问:把「是不是」改成「有哪些情况不是」,反问往往能得到另一面。第二步是要求出处:问它「这个说法的来源是什么」,工具给的出处必须自己走一遍,走不通就当它没给。第三步是找一个不依赖工具的来源:词典、教材、原版读物、可署名的研究。三步走完再决定用不用。前两步成本很低,第三步最容易被跳过,也最关键。
04条边界
三条边界。第一,本院没有对具体产品的错误率做测试,文中描述的是机制与现象,不是对某个工具的评价。第二,「必须核对」不是「不能用」,反对的是不核对地照用。第三,核对能降低风险,但无法归零;涉及医疗、法律等专业判断时,应交给相应的专业人士,本院的讨论仅限于学习场景。