AI 陪练的两条边界
AI 对话工具已经可以做到随时陪练,这在工具层面是真实进步。但它有一个容易被忽略的性质:它太愿意配合。本文提出两条边界——"顺从边界"与"标准边界",说明在什么情况下 AI 陪练有效,在什么情况下会加固学生的错误,并给出可操作的应对方式。
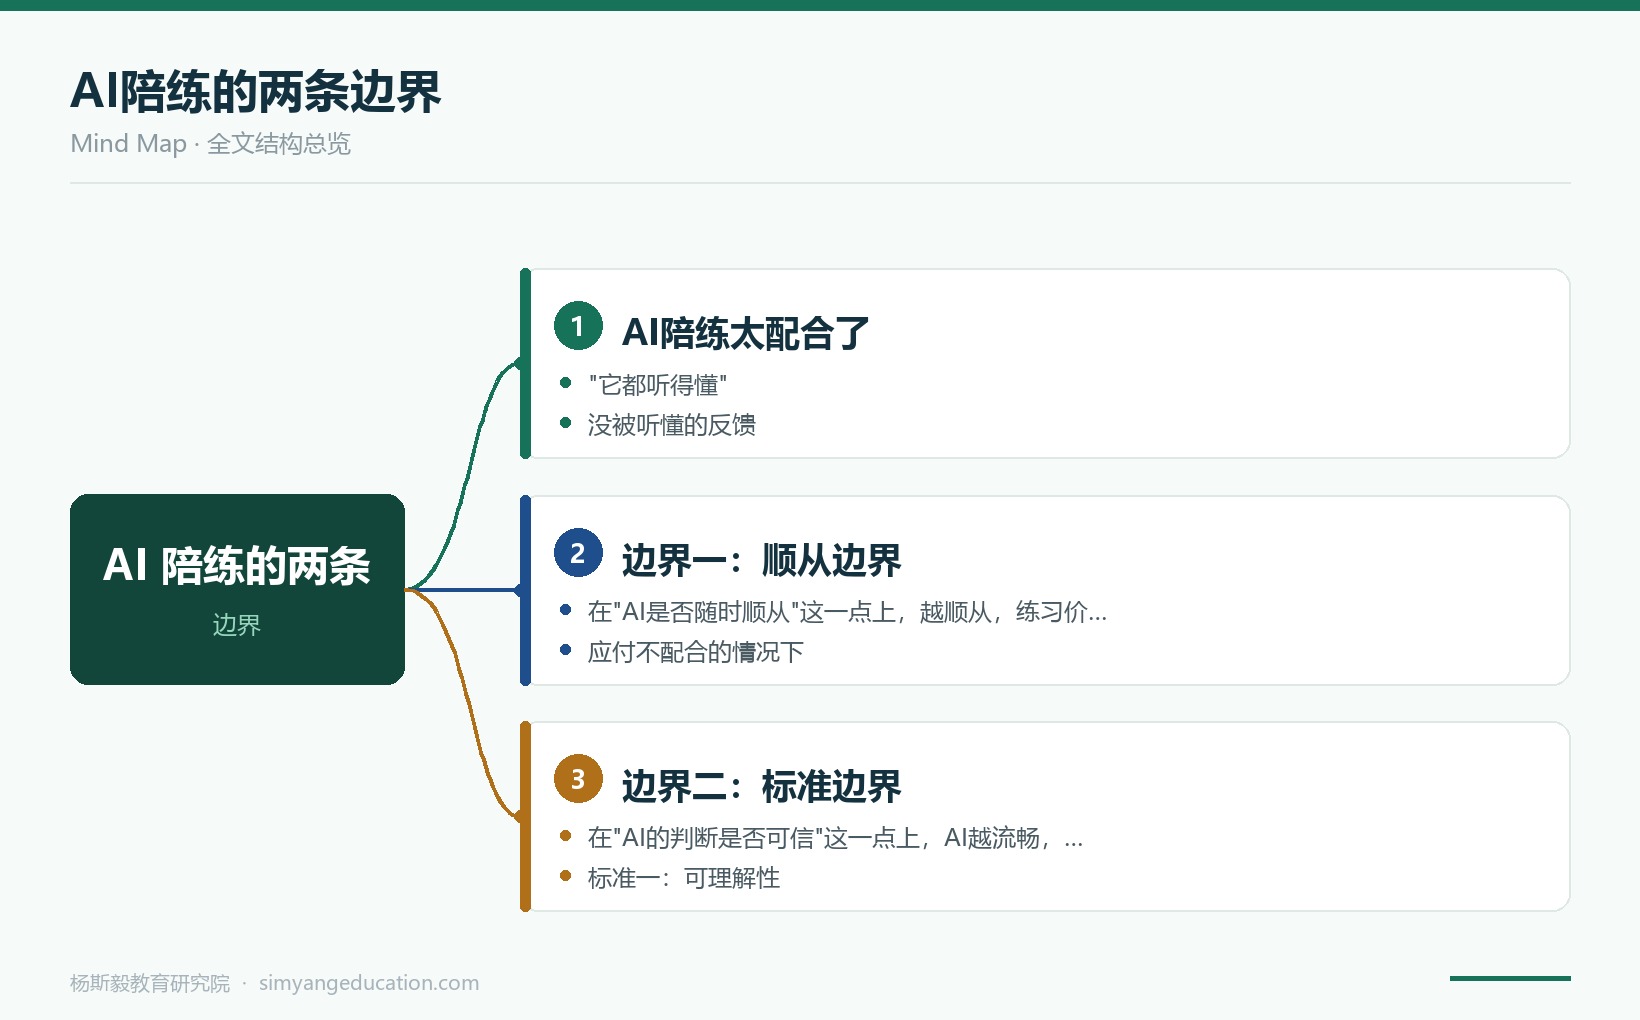
01AI 陪练太配合了
让一个学生和 AI 对话三轮,然后问他感受。答案通常是:很好,很顺畅,它都听得懂。
这三个评价恰恰指向问题。
"它都听得懂" ——一个真人对话者不会总是听得懂。真实交流里,对方会皱眉、会反问、会跑题。AI 把这些都抹平了,学生因此失去了最宝贵的一种反馈:没被听懂的反馈。
"很顺畅" ——顺畅意味着 AI 在主动适应学生的水平。它会顺着学生的表达补足意思,用学生熟悉的词回话。结果是,学生一直在安全区里练习。
"很好" ——很多 AI 的反馈以鼓励为主。夸赞本身没问题,但它不是信息。
02边界一:顺从边界
在"AI 是否随时顺从"这一点上,越顺从,练习价值越低。
原因很简单:语言能力是在应付不配合的情况下长出来的。学习者需要遇到听不懂、接不上、被误解,然后想办法补救。这些时刻才是能力增长点。
所以有效的 AI 陪练,必须主动把 AI 调成"不那么配合":
- 让它扮演一个不耐烦的店员
- 要求它只在真的理解时才回应,听不懂就明确说"我没听懂"
- 要求它不要替学生补完句子
- 设定它必须反问至少一次
这不是为了制造难度,而是为了恢复真实对话的必要摩擦。
03边界二:标准边界
在"AI 的判断是否可信"这一点上,AI 越流畅,越需要外部标准。
AI 生成的语言通常通顺,但通顺不等于得体。它会给出语法正确但语境不对的说法、会创造不存在但看起来合理的搭配、会使用过时或过于书面的表达。
如果学生把 AI 的"很好"当成标准,他会把错误固化成习惯——而且比自学时更难纠正,因为他有了"权威"背书。
因此,AI 陪练必须挂在两个外部标准上:
标准一:可理解性。 发音的目标是让人听懂,不是像某国人。判断标准是真人对这句话的反应,不是 AI 的评分。
标准二:真实语料。 学生应该定期接触真实材料——新闻、播客、影视——用来校准 AI 给的说法。AI 是练习场,真实语料是标尺。
04一个可用的配置
把上面两条边界合成一个可执行的配置:
- 角色 ——给 AI 一个具体、有点难缠的身份
- 规则 ——听不懂必须说,不许替学生补完,每轮至少反问一次
- 复盘 ——每轮结束,让 AI 只指出一处最影响理解的问题
- 校准 ——每周用一段真实材料对照,看看有没有被 AI 带偏
05结论
AI 陪练的价值是真实的,但它不是"多了一个会说英语的老师"。它更像是一个可以随时约到、且可以被你设定难度的对话对象。
它最大的风险不是说得不好,而是太好说话。
(本周内,AI 学习实验室将发布一份可直接复制使用的「不配合陪练」Prompt 结构,见 AI 学习板块。)