错误不是耻辱,是数据
2026-10-29 12:11:37
27146
本文导读
对错误的恐惧是语言学习里最贵的成本。本文提出把错误当数据处理:收集、分类、反馈、再测,并给出纠错的时机规则。
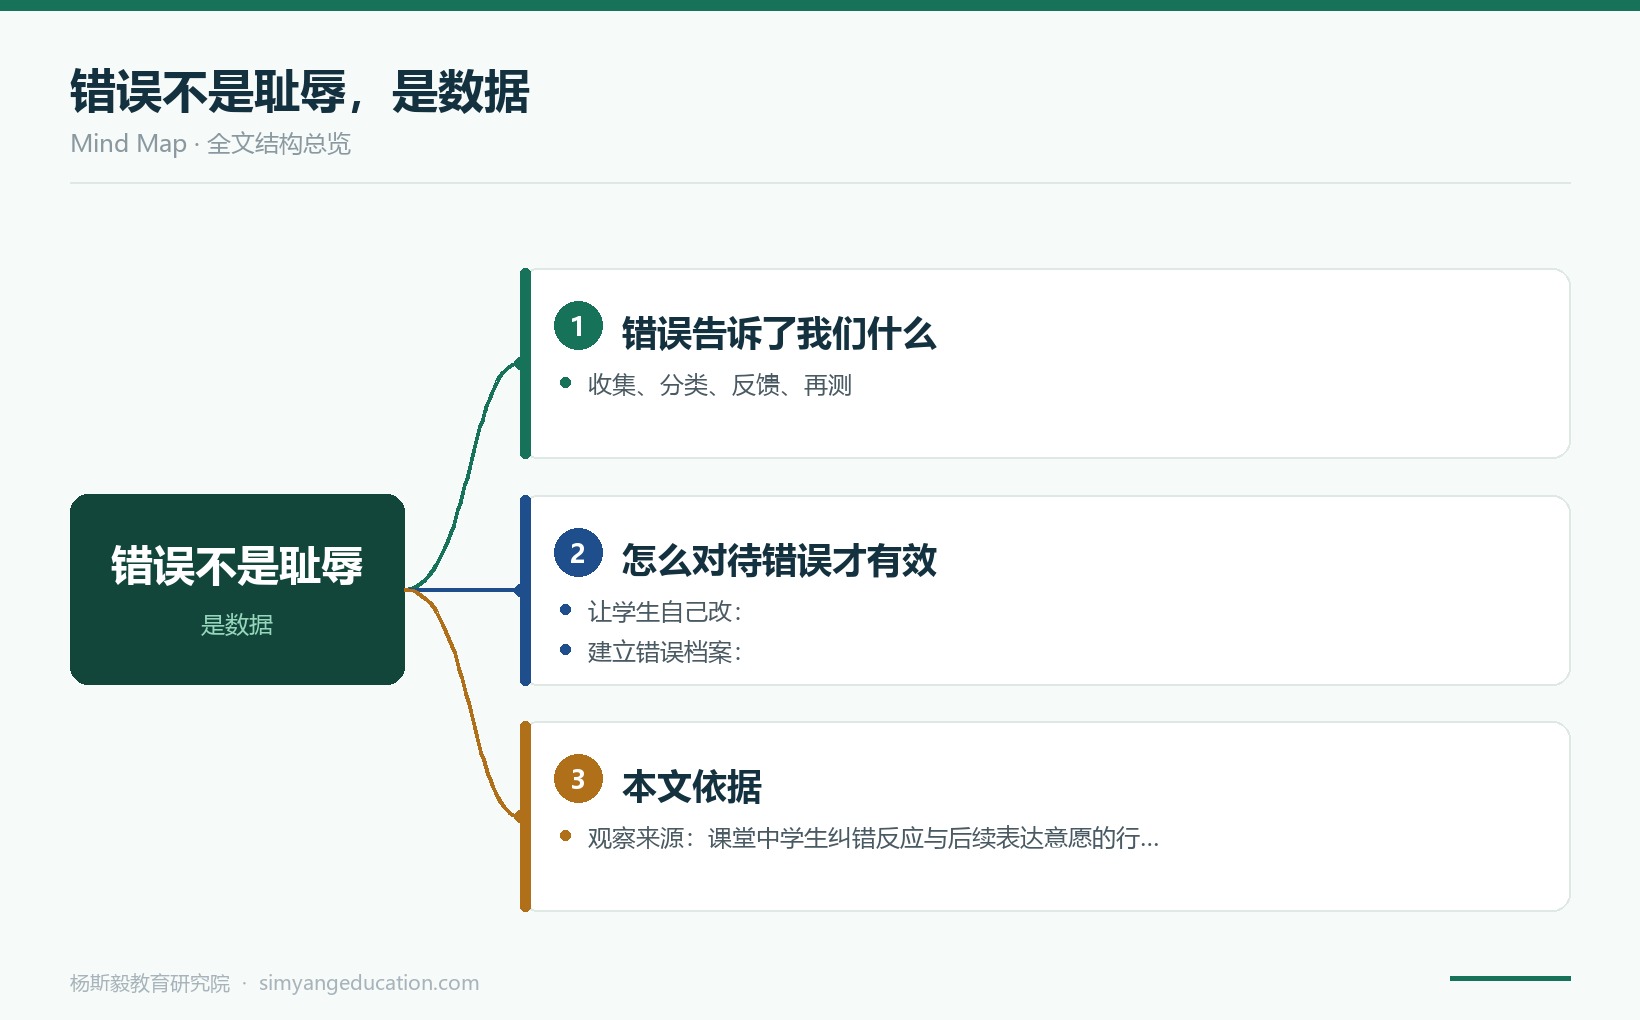
图 1 错误不是耻辱,是数据 —— 全文结构总览 · 点击图片可放大
本文性质:观察 证据标签:观察 Observation
对错误的恐惧是语言学习里最贵的成本——它让学习者闭嘴,而闭嘴的学习者失去了最重要的信息来源。
01错误告诉了我们什么
每一个错误都携带信息:它精确指出当前系统的边界在哪里。学生把完成时用在不该用的地方,说明完成时的边界在他的系统里还没建立——这是值得记录的诊断结果,不是值得羞愧的罪证。我们把错误当作数据来处理:收集、分类、反馈、再测。怕错的学习者会回避复杂表达,只说他有把握的句子,于是错误确实变少了,进步也停了。
02怎么对待错误才有效
- 区分类型:影响理解的错误优先处理,不影响理解的可以放过;
- 区分时机:流利度任务中不打断,准确度任务中即时纠正;
- 让学生自己改:教师提示而不代劳,自我修正留下的痕迹最深;
- 建立错误档案:同类错误反复出现,说明需要回到输入端补材料,而不是继续纠正。
「在困难与挫折中学习」并非坏事,相关机制见 合意困难。杨老师也多次在 杨老师说专栏 谈到师生该如何面对犯错。
图 2 错误不是耻辱,是数据 —— 分节要点 · 点击图片可放大
本文依据
观察 Observation模型 Model实证 Evidence
观察来源:课堂中学生纠错反应与后续表达意愿的行为记录;
模型出处:冲击波英语错误处理流程(收集—分类—反馈—再测),属于练习阶段的设计原则;
待验证项:「延迟纠错优于即时纠错」的适用边界在不同任务类型中尚无本院实证;
外部文献:Lightbown & Spada, How Languages Are Learned(关于纠错时机与方式的讨论)。
杨斯毅教育研究院
把研究放在课堂旁边 · 教育研究